
腾讯云国际 CVM 告警需要先保证 Agent 数据正常上报,再配置指标、阈值、持续时间、实例对象和通知模板。本文覆盖 CPU、内存、磁盘、带宽及无数据排查。
腾讯云国际 CVM 监控告警的正确目标,不是把 CPU、内存和磁盘都填一个固定百分比,而是建立一条可验证的响应链:指标能够持续上报,异常条件符合业务基线,告警绑定了正确实例和通知人,收到通知后知道先检查什么。
只创建告警策略但没有确认 Agent、通知模板和接收人,服务器真正异常时仍可能没人收到消息;阈值设置得过于敏感,又会产生大量无效通知,让关键告警被忽略。
CVM 监控应该覆盖哪些层级
腾讯云可观测平台可以展示 CVM 指标并配置告警,但资源指标只能说明某项资源是否异常,不能直接证明网站、API 或数据库是否可用。基础监控至少应覆盖资源、实例事件和业务验证三个层级。
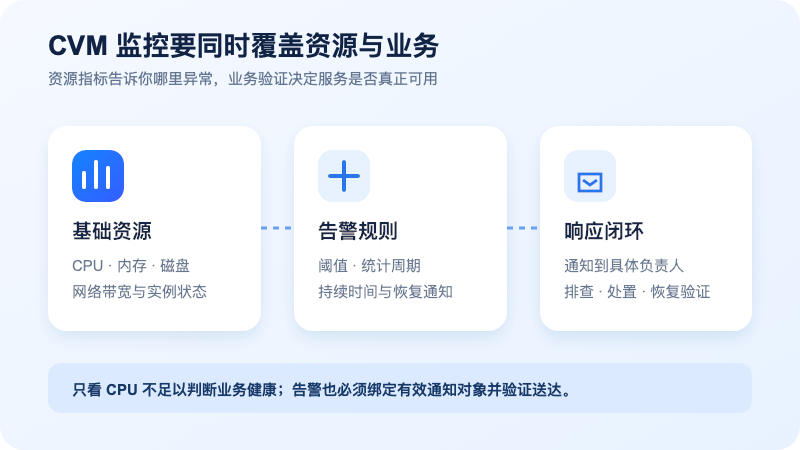
- 资源指标:CPU、内存、磁盘、网络带宽以及实例运行状态;
- 实例事件:无法 Ping 通、只读磁盘等平台可识别的异常事件;
- 业务状态:网站能否访问、API 是否返回成功、数据库连接和关键任务是否正常;
- 通知闭环:哪个负责人收到、多久重复通知、恢复时是否发送消息以及如何留档。
例如 CPU 使用率正常,不代表磁盘没有写满;磁盘利用率正常,也不代表 Nginx、应用进程或数据库连接没有异常。因此,CVM 指标适合发现资源和实例层问题,业务可用性仍需结合应用日志、健康检查或独立探测。
配置告警前,先确认监控数据正常上报
腾讯云官方文档说明,CVM 指标采集和告警依赖监控 Agent。若监控页面没有数据,应先处理数据上报,而不是继续调整告警阈值。
Linux CVM 可以先执行以下只读命令,确认 Agent 的计划任务与相关进程。命令不会修改系统配置:
crontab -l | grep stargate
ps ax | grep sgagent
ps ax | grep barad_agent
有计划任务且相关进程正常存在,才说明 Agent 基础运行状态具备。命令输出中可能包含 grep 自身,判断时不要把这一行误认为 Agent 进程。
Windows CVM 可以打开服务管理,检查 QCloud BaradAgent Monitor 和 QCloud Stargate Manager 是否存在并处于运行状态;也可以在任务管理器中检查 BaradAgent 和 sgagent 进程。
Agent 正常但仍无数据时,还应检查实例是否关机或重启、系统负载是否过高,以及上报域名能否正常解析。官方排障资料列出的相关域名包括:
update2.agent.tencentyun.com
receiver.barad.tencentyun.com
custom.message.tencentyun.com
metadata.tencentyun.com
这些是需要被系统正确解析的域名,不是让用户直接写入固定 IP。若实例曾修改系统 DNS,应先核对腾讯云当前私网 DNS 说明,避免用过期地址覆盖系统配置。Agent 恢复后还需要等待数据重新上报,再检查监控曲线。
CPU、内存、磁盘和网络告警怎么理解
CPU 使用率:区分瞬时尖峰和持续高负载
短时间 CPU 升高可能来自发布、压缩、日志轮转或定时任务;持续高负载才更可能影响请求延迟。告警条件应同时考虑阈值、统计周期和连续数据点,不建议看到一次尖峰就立即触发严重告警。
腾讯云官方示例使用“CPU 超过 80%、5 分钟周期、连续两个周期”说明配置方法,这只是示例,不是所有业务的通用阈值。正式值应参考该实例一段时间的正常曲线、峰值时段和可接受延迟。
内存使用率:先确认指标数据来源
内存指标依赖实例内 Agent 正常采集。内存持续升高时,应进一步检查进程占用、缓存行为、交换空间和是否发生 OOM,不能直接通过重启掩盖内存泄漏。
Linux 可以使用以下只读命令查看当前内存概况和主要进程,结果只代表检查时刻:
free -h
ps aux --sort=-%mem | head
如果控制台内存曲线缺失,而服务器命令能看到实际占用,应优先排查 Agent 上报链路。
磁盘利用率:容量和 inode 都要检查
磁盘使用率接近上限时,数据库、日志和临时文件可能无法继续写入。Linux 除容量外还要检查 inode;大量小文件可能在容量尚未耗尽时先耗尽 inode。
df -Th
df -ih
第一条检查文件系统容量,第二条检查 inode。若确实需要扩展云硬盘,应先参考《腾讯云国际 CVM 云硬盘扩容教程》,不要只在控制台增加 CBS 容量。
网络带宽:告警应对应实际购买上限
公网带宽利用率需要结合实例当前带宽上限理解。同样的流量,在不同带宽配置下代表的压力不同。持续接近上限可能导致访问延迟或丢包,但也要区分正常业务峰值、批量传输和异常流量。
如何建立一条可用的 CVM 告警策略
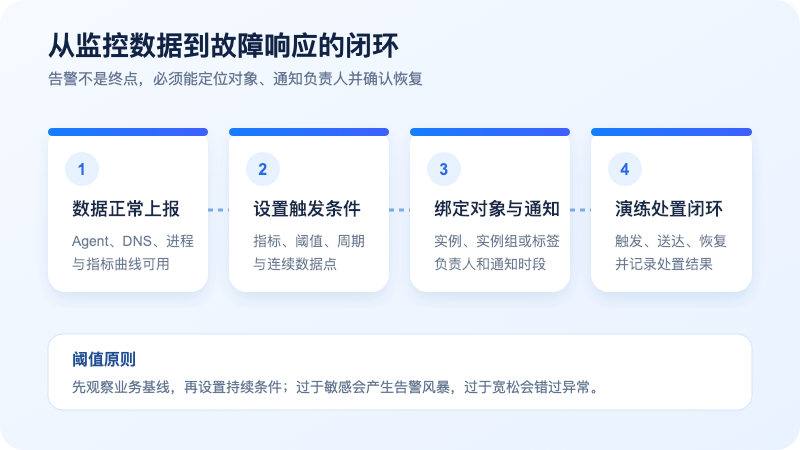
- 确定策略类型:选择 CVM 对应的监控策略,不要把数据库或负载均衡指标混入同一策略。
- 选择告警对象:可以按实例、实例组、全部对象或标签关联;生产与测试环境建议分开。
- 配置触发条件:明确指标、比较方式、阈值、统计周期、持续数据点和重复通知频率。
- 绑定通知模板:确认接收人、通知渠道、通知时段、触发通知和恢复通知。
- 保存并检查关联:确认策略已启用,目标 CVM 确实出现在关联对象中。
- 执行告警演练:在可控环境验证通知能送达,并记录负责人收到通知后的检查顺序。
策略名称建议能看出环境、对象和指标,例如“生产站点-CVM-磁盘利用率”,而不是统一命名为“服务器告警”。实例数量增加后,可以结合资源标签或实例组批量关联,但标签本身也需要稳定维护。
阈值应该怎么定,才不会产生告警风暴
阈值不是越低越安全。过低会把正常峰值变成异常,重复通知过于频繁则会快速消耗注意力。更合理的步骤是:
- 观察工作日、周末、发布时段和业务高峰的历史曲线;
- 确定真正影响响应时间或写入能力的资源边界;
- 用持续多个数据点过滤瞬时波动;
- 为预警和严重异常设置不同处理优先级;
- 保留恢复通知,确认问题是否真正结束;
- 每次误报或漏报后调整策略并留下原因。
腾讯云提供 CVM 默认告警策略,但默认策略仍需要关联有效接收人才能收到通知。默认规则适合做基础兜底,不代表已经匹配具体网站、数据库或 API 的业务容忍度。
收到告警以后应该先检查什么
告警内容应能定位实例、区域、指标、当前值、开始时间和策略名称。收到通知后,先确认它是持续异常还是已经恢复,再按指标进入对应排查:
- CPU:检查高占用进程、定时任务、发布操作和请求增长;
- 内存:检查进程、缓存、交换空间、OOM 记录和服务重启;
- 磁盘:检查容量、inode、日志、数据库目录和真实挂载点;
- 带宽:检查入口流量、批量任务、攻击流量和带宽上限;
- 无数据:检查实例状态、Agent、DNS、进程和系统负载;
- 无法 Ping 通:继续检查实例状态、网络、安全组和系统防火墙。
涉及网络访问控制时,可结合《腾讯云国际 CVM 安全组配置教程》检查。处置完成后不要只关闭告警,应确认指标恢复、业务请求正常,并记录根因和修正措施。
常见问题
创建告警策略后为什么没有收到通知?
检查策略是否启用、是否绑定正确实例、通知模板是否有有效接收人、当前时间是否在通知时段内,以及指标数据是否正常上报。默认策略也需要关联接收人。
监控页面为什么没有内存或磁盘数据?
常见原因是 Agent 未安装、进程异常、DNS 解析失败、实例关机或负载过高。先检查 Agent 和上报链路,恢复后等待新的数据点出现。
CPU 告警设置 80% 合适吗?
80% 只是官方示例中的阈值之一,不是通用答案。应结合实例正常基线、峰值时段、统计周期、持续时间和业务延迟确定。
有 CVM 告警以后还需要网站监控吗?
需要。CVM 指标反映资源和实例状态,不能完整验证域名解析、TLS、Web 服务、应用依赖和接口返回。关键业务还应建立独立可用性检查。
官方资料
- Tencent Cloud International:Creating Alarm Policy
- Tencent Cloud International:Installing CVM Agents
- Tencent Cloud International:CVM Has No Monitoring Data
- Tencent Cloud International:Default Alarm Policy
- Tencent Cloud International:Creating Notification Template
如果需要确认腾讯云国际 CVM 的基础监控、磁盘、安全组或账号使用方向,可以通过 Telegram 联系 @heishayun,说明实例区域、系统版本和当前现象后再沟通。
 联系 Telegram 客服
