
从运维责任、控制能力、状态管理、扩缩容和平台限制比较云服务器、容器平台与 Serverless,并给出最小验证方法。
2026 年默认建议:小团队和传统有状态应用先用云服务器;服务数量多、已有容器镜像和平台运维能力时选择托管容器;事件触发、短时、无状态任务适合 Serverless。不能只比计算单价,还要算集群空闲、请求、日志、网络和工程师维护。
需要完整系统控制、长期进程或遗留软件时优先评估云服务器;已经形成镜像、持续交付和多服务体系时再考虑容器平台;事件驱动、流量不连续且执行边界明确的功能适合 Serverless。架构可以混合使用,不必整站只选一种。
先确定团队愿意管理到哪一层
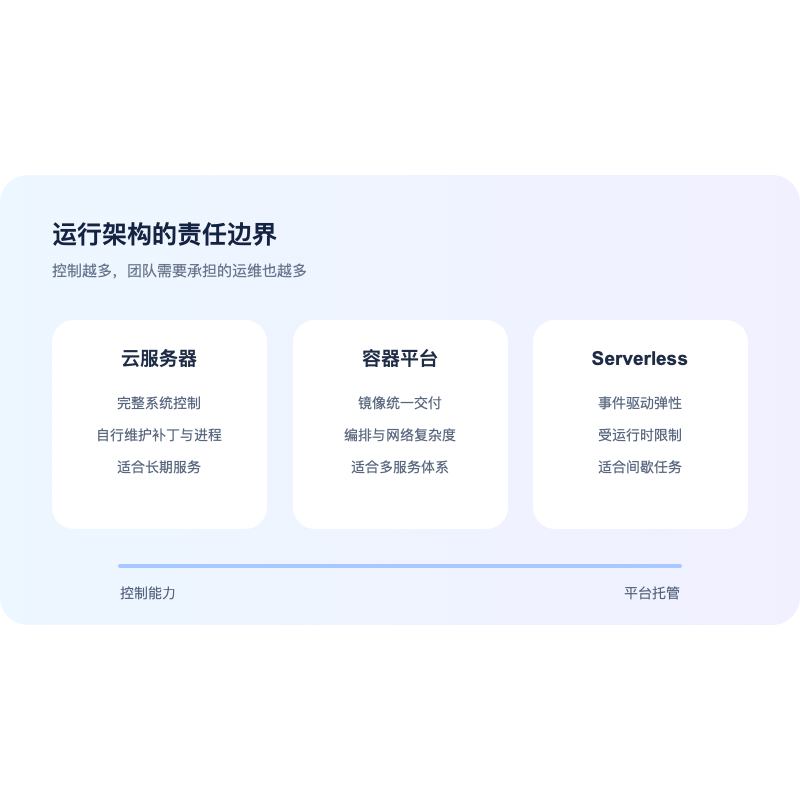
| 维度 | 云服务器 | 容器平台 | Serverless |
|---|---|---|---|
| 团队管理 | 系统、补丁、运行时、进程与扩缩容 | 镜像、编排配置;集群责任视产品而定 | 函数或服务代码、权限与事件配置 |
| 控制能力 | 最高 | 较高且交付标准化 | 受运行时和平台限制 |
| 典型负载 | 传统应用、数据库、长期服务 | 微服务、API、批处理、统一交付 | 事件处理、Webhook、间歇任务 |
| 主要风险 | 补丁、安全与容量维护 | 编排、网络、存储与可观测性复杂度 | 冷启动、限制、调试与厂商耦合 |
什么时候继续使用云服务器
- 应用依赖特定操作系统、内核模块或本地软件;
- 需要长期进程、固定网络行为或完整主机控制;
- 当前只有少量服务,容器编排收益不足;
- 团队已有成熟的主机安全、备份、监控和发布流程。
云服务器简单的是产品模型,不代表生产运维自动简单。系统补丁、SSH 权限、密钥轮换、磁盘容量、日志、备份和故障恢复都需要明确负责人。
什么时候采用容器平台
容器适合把应用、依赖和启动方式固化为镜像,并在测试与生产之间保持一致。服务数量增加、需要滚动更新、自动扩缩容或统一资源调度时,容器平台的价值会更明显。
但容器不等于 Kubernetes。小团队可以先使用托管容器服务或 Serverless 容器,避免过早承担控制面、节点、网络插件、入口、证书、存储类和升级工作。只有当 Kubernetes 的 API、生态或调度能力确实解决问题时,再承担对应复杂度。
什么时候采用 Serverless
Serverless 适合由 HTTP、消息、对象上传或定时器触发的短时任务,也适合流量间歇、希望自动缩放到低资源占用的应用。AWS Lambda、Google Cloud Run/Functions 和 Azure Functions 的运行模型并不完全相同,超时、并发、网络、磁盘、启动和计费单位需要分别核对。
如果任务持续运行、依赖稳定低延迟、需要特殊系统权限或存在大量跨服务调用,Serverless 可能增加成本和排障难度。数据库连接、重试、幂等和可观测性也必须由应用设计处理。
混合架构往往更实际
常见组合是:核心数据库运行在托管数据库或稳定计算资源上,Web/API 使用容器,图片处理和异步通知使用 Serverless,临时批处理使用 Spot 工作节点。边界应按状态、持续时间、扩缩容模式和故障影响划分,而不是按开发语言划分。
迁移前做一次最小验证
- 记录当前启动时间、峰值并发、内存、磁盘和网络依赖;
- 选择一条非核心业务链路做镜像或函数化;
- 验证发布、回滚、日志、告警、密钥和数据库连接;
- 模拟实例退出、容器重建或函数重试;
- 比较真实账单和团队维护时间,再决定扩大范围。
常见问题
用了 Docker 就需要 Kubernetes 吗?
不需要。Docker Compose、托管容器服务和 Serverless 容器都能运行容器,应根据服务规模和编排需求决定。
Serverless 就没有服务器和运维了吗?
服务器由平台管理,但应用仍需处理权限、依赖、监控、重试、数据一致性、成本和安全边界。
容器一定比云服务器省钱吗?
不一定。容器可以提高资源利用率,但集群基线、负载均衡、日志、跨区流量和运维人力也会形成成本。
按愿意管理到哪一层选择
| 方式 | 团队负责 | 不适合 |
|---|---|---|
| 云服务器 | 系统、补丁、扩缩、应用 | 大量服务需频繁调度 |
| 托管容器 | 镜像、编排、策略、可观测 | 团队没有容器能力 |
| Serverless | 代码、事件、状态外置 | 长连接、特殊运行时或持续高负载 |
最小验证与回退
用真实请求测试冷启动、超时、并发、网络、日志、部署回滚和月成本。状态先外置,旧部署保留,小比例切流。新平台限制或成本不合适时恢复旧入口与旧消费者,不能一次关闭原系统。
云服务器、容器平台和 Serverless 怎么选现场验收单
- 入口或命令:目标云计算/容器/函数购买页核对运行时、限制、区域和价格
- 提交前风险:计算、集群、请求、流量、日志和空闲资源均可能收费;迁移可能改变状态与网络
- 不能继续时:有状态应用、冷启动、运行时限制、容器平台复杂度、可观测缺失、锁定
- 完成证据:真实负载下部署、扩缩、故障、日志、成本和回滚均通过
- 退出办法:保留旧部署和数据路径,先镜像流量/小比例切换,失败恢复旧入口
完成这项任务后继续检查
官方资料
需要结合现有应用、团队能力和目标平台确定运行方式,可以通过 Telegram 联系 @heishayun。正式迁移前应先完成可回滚的小范围验证。
 联系 Telegram 客服
