
区分数据库优化升配、只读副本和分库分表解决的瓶颈,并给出验证流程。
数据库变慢或容量增长时,常见选择包括升配与优化、增加只读副本、分库分表。三者解决的问题不同:升配改善单节点资源,只读副本分担读请求,分库分表拆分数据和写入压力。没有定位瓶颈就直接分片,通常会把性能问题变成长期工程复杂度。
默认顺序:先修慢 SQL、索引和连接池,再做小步升配;读流量明显高于写流量且允许短暂复制延迟时,增加只读副本;只有单库容量、写入吞吐或维护窗口已经触及上限,才进入分库分表。三种方案都会增加资源或迁移费用,改架构前先做可恢复备份和真实负载基线。
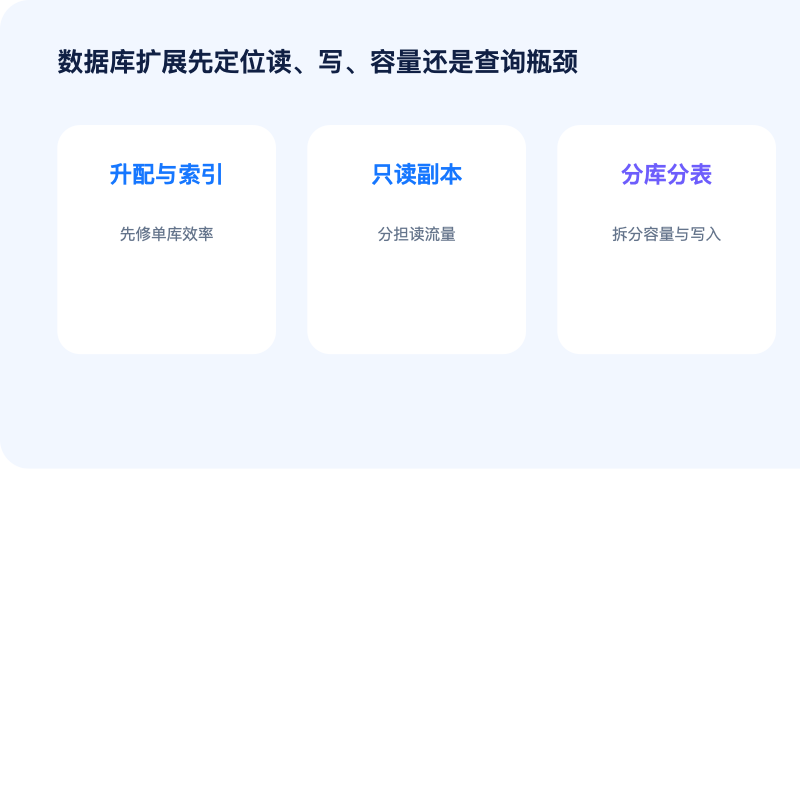
三种方法分别解决什么
| 方式 | 主要解决 | 新增复杂度 |
|---|---|---|
| 索引优化与升配 | 低效查询、CPU、内存、IO 瓶颈 | 较低,但存在单机上限 |
| 只读副本 | 可容忍复制延迟的读流量 | 读写路由与一致性处理 |
| 分库分表 | 单库容量、写吞吐或租户隔离 | 路由、事务、查询与迁移复杂度高 |
第一步通常不是增加节点
先检查慢查询、索引、执行计划、锁等待、连接池、磁盘延迟和缓存命中。一个缺失索引可能让所有副本重复执行低效查询;升配如果没有解决锁争用,也不会线性提高吞吐。
只读副本的适用边界
报表、内容浏览和允许短暂延迟的查询可以路由到副本。创建订单后立即查询、权限变更后马上校验等“读己之写”场景,可能仍需访问主库。应用必须识别复制延迟和副本故障,不能假设所有读取都可无条件迁移。
什么时候才考虑分库分表
- 单库经过优化和合理升配后仍无法满足容量或写吞吐。
- 存在稳定、均匀且可长期使用的分片键。
- 团队能处理跨分片查询、事务、唯一约束和数据迁移。
- 已有完善的路由、监控、备份和扩容工具。
验证流程
- 按读、写、容量、锁和查询效率分类瓶颈。
- 先验证索引与查询优化的收益。
- 用真实复制延迟测试只读路由和故障回退。
- 分片前模拟热点键、扩容迁移和跨分片查询。
- 测试备份恢复能否覆盖全部分片并保持一致时间点。
边界条件
托管数据库的只读副本、一致性、自动故障切换和分片产品能力因平台而异。分库分表不是普通升配操作,回退成本较高,应保留明确的架构决策记录。
先用证据给瓶颈归类
| 证据 | 优先动作 | 不要误判 |
|---|---|---|
| 少数 SQL 扫描量大 | 索引、查询和表结构 | 副本会复制同样的坏查询 |
| 内存/CPU持续饱和且SQL合理 | 评估升配 | 升配有规格上限和维护影响 |
| 读多写少、报表挤占主库 | 只读副本 | 副本不是写扩展 |
| 单表/单库写入和容量达上限 | 评估分片 | 分片引入路由与事务复杂度 |
只读副本不是“无感复制”
应用要区分写连接和读连接,并为“刚写完立即读取”保留主库路径。监控复制延迟、回放错误和副本容量;延迟超阈值时将关键读取切回主库。报表、搜索和可容忍旧数据的列表适合读副本,支付状态、库存扣减和权限变更不应默认读取滞后副本。
什么条件下才值得分片
必须先有稳定的分片键、可预测的数据分布和跨分片查询清单。按租户或用户 ID 分片时要检查大客户热点;按时间分片要考虑跨周期查询。全局唯一 ID、事务、分页、聚合、扩容重平衡、备份和故障恢复都要单独设计。团队没有自动路由、观测和重平衡能力时,分片成本通常高于继续优化或升配。
迁移如何避免一次性切换
- 从生产基线复制脱敏或隔离数据,验证索引和查询计划。
- 只读副本先承接低风险查询;分片先对新租户或小比例数据灰度。
- 核对行数、校验和、延迟、错误率和账单,再扩大比例。
- 在切写前准备冻结、双写校验或增量追赶方案,并明确唯一事实源。
验收与回退
使用真实查询分布对比 P95/P99 延迟、数据库 CPU、IO、锁等待、连接数、复制延迟和失败率;执行一次隔离恢复证明备份可用。旧主库和旧连接配置保留为只读回退点。副本异常就撤回读路由;分片异常则停止扩大流量并切回旧路由,处理灰度期间新增写入后再决定是否重试。不要在数据已分叉时直接双向回切。
费用应按稳定容量计算
升配要看目标规格长期费用和维护窗口;只读副本不仅有实例费,还有存储、备份和可能的跨区传输;分片会增加数据库实例、代理、监控、备份与工程人力。把一次压测的峰值结果换算成至少一个完整业务周期,并预留增长和故障冗余。成本更低但无法在副本延迟或单分片故障时恢复的方案不能通过选型。
决策记录要写明当前瓶颈证据、选择方案、否决方案和重新评估阈值。例如复制延迟超过业务容忍值时关键读回主库,单分片容量达到预警线时启动扩容演练。没有阈值,团队会在故障中临时争论,无法安全执行回退。
完成当前任务后继续检查
官方资料
需要核对目标平台的数据库规格和只读能力时,可联系黑鲨云 @heishayun。
 联系 Telegram 客服
