
从事务、数据模型、查询、扩展和团队成本比较关系型数据库与各类 NoSQL。
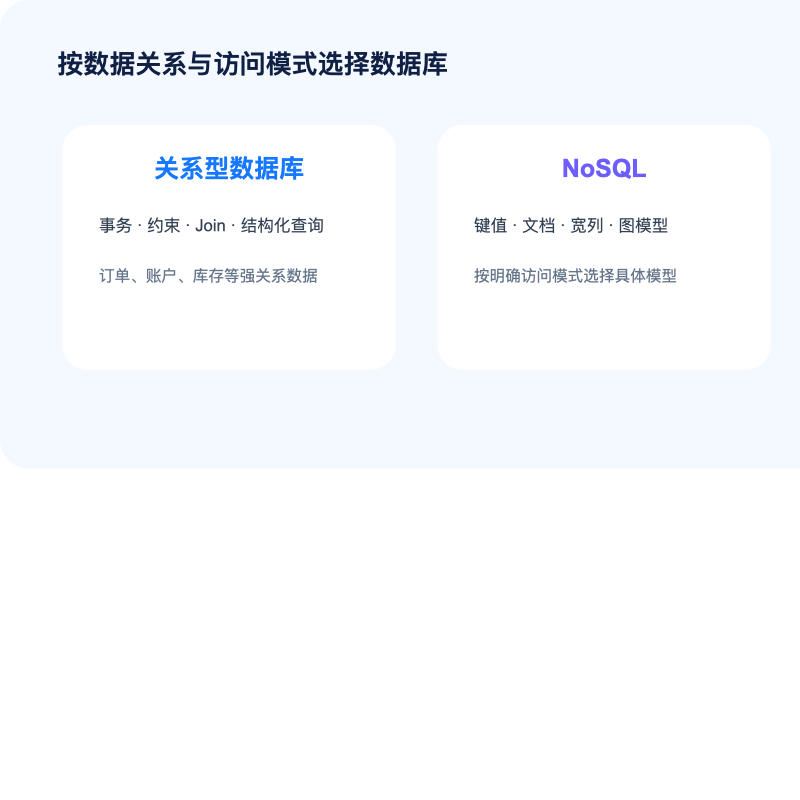
关系型数据库和 NoSQL 不是新旧技术关系。前者擅长事务、约束、关联查询和成熟 SQL 生态;NoSQL 是键值、文档、宽列、图等多类数据模型的统称,通常围绕特定访问模式取舍一致性、查询灵活性和扩展方式。
默认建议:订单、账务、库存和需要多记录事务的系统优先关系型数据库。只有访问模式稳定、模型适合键值、文档或宽列等具体类型,并能接受查询与一致性边界时才采用 NoSQL。NoSQL 不是“更快的 SQL”,迁移前必须用真实查询建模。
先给结论
订单、账户、库存和结算等需要多行事务、唯一约束和复杂关联的数据,通常先选择关系型数据库。会话、缓存、灵活文档、时序或大规模键值访问,应根据主访问模式评估对应 NoSQL 类型。多数中小系统不需要一开始就引入多种数据库。
核心差异
| 判断项 | 关系型 | NoSQL |
|---|---|---|
| 数据模型 | 表、关系、约束 | 键值、文档、宽列、图等 |
| 事务 | 多表 ACID 是常见强项 | 能力因产品和模型而异 |
| 查询 | SQL、Join、聚合成熟 | 通常围绕预先设计的访问模式 |
| 结构变化 | Schema 管理明确 | 部分模型更灵活,但仍需数据治理 |
不要从“数据量大”直接推导 NoSQL
关系型数据库也能纵向扩展、读写分离、分区和分片;NoSQL 也会遇到热点键、二级索引成本、一致性取舍和跨分区查询问题。真正的问题是:一次请求按什么键访问、是否跨实体事务、能否接受最终一致、查询模式是否稳定。
实用决策流程
- 列出核心实体、关系、约束与事务边界。
- 统计最重要的读写路径、查询条件、排序和聚合。
- 确认一致性、延迟、吞吐、地域分布和数据生命周期。
- 用候选数据库实现最难的三条查询,而不是只做简单写入跑分。
- 评估备份恢复、迁移、观测、人员能力和退出路径。
组合使用要克制
一个系统可以用关系型数据库保存交易事实,用缓存承担热点读取,用文档库保存高度灵活的数据。但每增加一种存储,就增加一致性、备份、监控和故障处理成本。应从一种主存储开始,由明确瓶颈推动拆分。
边界条件
不同 NoSQL 产品提供的事务、索引和一致性能力差异很大,不能用一个结论概括。托管产品的区域、配额和接口限制也需逐项核对。
用业务动作定义事务
把创建订单、扣库存、记录付款和修改权限写出需要同时成功或失败的数据。需要跨多行多表一致提交、组合筛选和临时报表时,关系型更直接。每次访问围绕单一键或聚合文档、很少跨对象事务时,特定 NoSQL 才可能合适。
| 问题 | 关系型 | 特定NoSQL |
|---|---|---|
| 数据关系 | 关联多、约束强 | 聚合边界清楚 |
| 查询 | 组合筛选、连接 | 固定访问路径 |
| 一致性 | 多记录强事务 | 可接受局部/最终一致 |
| 扩展 | 先优化与副本 | 模型适合分区 |
NoSQL 还要选类型
键值、文档、宽列、时序和图数据库能力不同。先确定分区键,估算热点和单项大小,列出查询与排序;需要全库扫描或频繁新增索引的需求必须提前暴露。
迁移、验收和回退
历史数据先做转换校验,记录无法映射的字段与约束。保持一个写入事实源,可用变更日志同步并双读比对,不可直接双写。验收业务正确性、P95、错误率、热点、扩容、备份和时间点恢复。关键事务无法表达、查询大量扫描或恢复不足时停止扩大流量;保留旧库与回放位置,处理增量后回切。
备份和运维能力也是选型条件
确认目标数据库支持所需的时间点恢复、跨区域副本、审计、加密、数据导出和版本升级。团队要能读懂慢查询或热点分区指标,并在容量逼近限制前处理。某产品吞吐很高但无法按业务对象恢复、查询工具不足或只有少数人理解数据模型,会把故障恢复变成更大风险。
允许组合,但要明确事实源
关系库保存订单事实,搜索或文档库承接派生查询是常见组合。派生库可以重建,不应反向成为账务事实。同步延迟、失败重放和删除传播必须监控;用户看到旧数据时,产品流程要有明确容忍边界。
上线前还要验证删除、过期和唯一性。NoSQL 中缺少关系约束时,应用必须承担重复数据、孤儿记录和并发更新;关系库也不能依赖无限外键和同步报表拖慢交易。用真实失败场景测试重试与幂等,确认同一请求重复执行不会产生两笔订单或覆盖新版本数据。
最终选择必须写明复核日期和触发重评的容量、延迟与错误率阈值,避免数据库类型成为不可讨论的长期假设。
完成当前任务后继续检查
官方资料
需要核对目标云平台的数据库产品时,可联系黑鲨云 @heishayun。
 联系 Telegram 客服
