
两者都能传消息,但日志分区与交换机队列模型不同。选型应从顺序、重放、路由、堆积和消费者语义出发。 本文说明操作前检查、执行顺序、结果验证和风险边界。
两者都能传消息,但日志分区与交换机队列模型不同。选型应从顺序、重放、路由、堆积和消费者语义出发。
本文解决的是“Kafka RabbitMQ 选型”这一项具体问题。判断时不能只看控制台是否存在某个按钮,还要同时核对账户、地域、资源状态、依赖关系和完成后的验证证据。页面名称与功能范围可能随平台版本调整,实际操作应以当前控制台和官方文档为准。
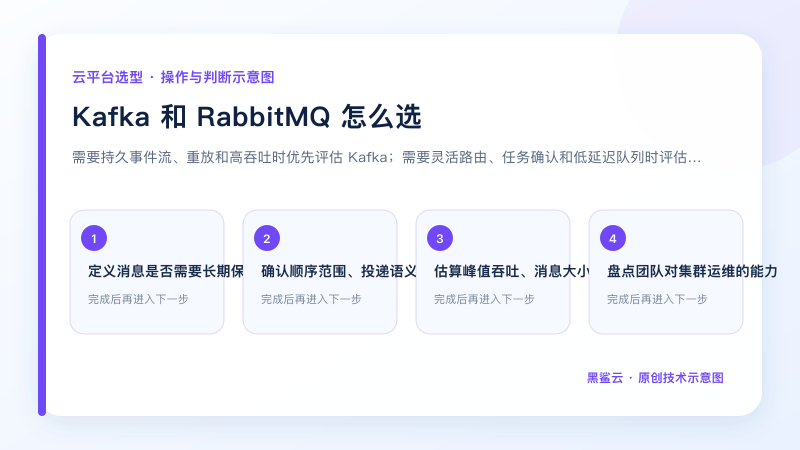
先给结论
两者都能传消息,但日志分区与交换机队列模型不同。选型应从顺序、重放、路由、堆积和消费者语义出发。
如果当前信息不足,不要直接套用别人的配置或截图。先把业务目标转成可验证条件:需要解决什么问题、允许影响哪些资源、失败后如何恢复、最终用什么指标判断成功。这样即使平台界面变化,也不会失去操作依据。
操作前需要确认什么
- 定义消息是否需要长期保留和重放
- 确认顺序范围、投递语义和幂等性
- 估算峰值吞吐、消息大小和堆积时长
- 盘点团队对集群运维的能力
这些检查项的作用是把“想要完成的结果”和“当前真实环境”对应起来。尤其是生产资源,实例名称、产品名称和账户昵称都可能相似,必须使用账户 ID、地域、资源 ID、时间窗口或账单记录完成二次核对。
建议按以下顺序处理
- 1. 用真实消息建立生产消费样本
完成这一步后应立即保存结果或截图,并用下一步的验证条件确认状态。若实际页面、资源状态或返回结果与预期不一致,先停止扩大操作范围,再检查权限、地域、账户和依赖关系。
- 2. 测试消费者故障和重复投递
完成这一步后应立即保存结果或截图,并用下一步的验证条件确认状态。若实际页面、资源状态或返回结果与预期不一致,先停止扩大操作范围,再检查权限、地域、账户和依赖关系。
- 3. 模拟长时间堆积后的恢复速度
完成这一步后应立即保存结果或截图,并用下一步的验证条件确认状态。若实际页面、资源状态或返回结果与预期不一致,先停止扩大操作范围,再检查权限、地域、账户和依赖关系。
- 4. 验证扩分区或扩队列的影响
完成这一步后应立即保存结果或截图,并用下一步的验证条件确认状态。若实际页面、资源状态或返回结果与预期不一致,先停止扩大操作范围,再检查权限、地域、账户和依赖关系。
- 5. 比较托管与自建的监控和运维成本
完成这一步后应立即保存结果或截图,并用下一步的验证条件确认状态。若实际页面、资源状态或返回结果与预期不一致,先停止扩大操作范围,再检查权限、地域、账户和依赖关系。
批量操作时建议采用少量对象验证、分批扩大、持续观察的节奏。任何一步出现异常,都应先保存现场信息,包括准确时间、错误代码、资源 ID 和已经执行的动作,避免重复尝试覆盖最早的故障证据。
完成后如何验证
| 序号 | 验证项目 | 合格依据 |
|---|---|---|
| 1 | 故障恢复后是否丢失或重复消息 | 页面状态、监控或平台账单与预期一致 |
| 2 | 单个慢消费者是否影响其他业务 | 使用另一会话、节点或时间窗口复核 |
| 3 | 扩容是否改变顺序或路由语义 | 保留结果并确认具备回退或后续处理路径 |
“控制台提示成功”只代表请求被受理或某个后台任务完成,不一定代表真实业务链路已经恢复。至少需要一次独立验证;涉及网络、数据库、权限或充值的操作,还应从使用者实际入口复核。
常见误区与风险边界
1. “恰好一次”不能替代业务幂等设计
这类问题容易在批量变更、故障期间或只核对单一指标时被忽略。正式操作前要明确影响范围,先在最小对象上验证;涉及数据、权限、网络或付款的信息,应保留可追踪记录并避免在公开渠道暴露敏感凭据。
2. 只按峰值吞吐选择会忽略消费模型
这类问题容易在批量变更、故障期间或只核对单一指标时被忽略。正式操作前要明确影响范围,先在最小对象上验证;涉及数据、权限、网络或付款的信息,应保留可追踪记录并避免在公开渠道暴露敏感凭据。
3. 无界保留会造成存储持续增长
这类问题容易在批量变更、故障期间或只核对单一指标时被忽略。正式操作前要明确影响范围,先在最小对象上验证;涉及数据、权限、网络或付款的信息,应保留可追踪记录并避免在公开渠道暴露敏感凭据。
云平台策略、产品能力、可用地域和计费规则会变化。本文不虚构固定价格、到账时效、库存、平台审批结果或不受限制的能力。涉及账户限制时,黑鲨云可协助核验;腾讯云国际和阿里云国际账户如因用户业务违规受到限制,可按实际状态协助核验可转移余额,最终结果仍取决于平台规则和账户实际状态。
执行记录建议保留哪些信息
建议记录操作日期、执行人、平台与地域、账户或资源 ID、变更前状态、具体动作、验证结果和回退位置。敏感密码、MFA 恢复码、API Secret、完整收款地址不应写入普通工单、公开截图或无权限隔离的表格。
 联系 Telegram 客服
